AI Skill 이란 무엇인가?
AI Skill 이란 무엇인가?
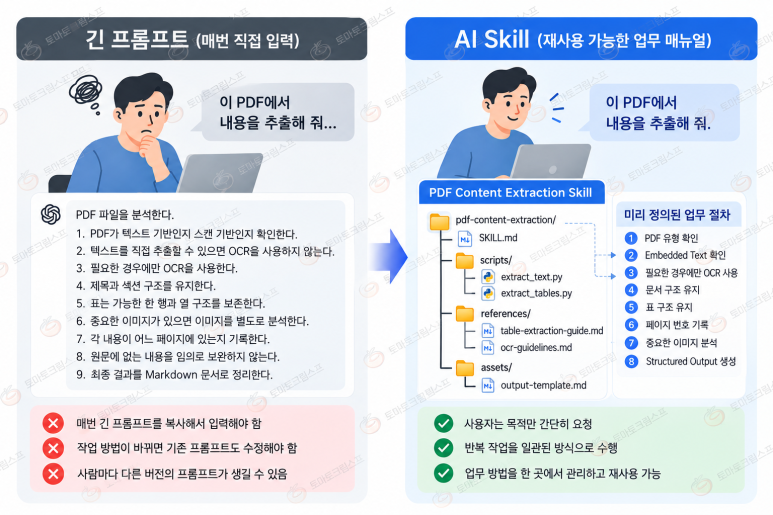
긴 프롬프트에서 재사용 가능한 AI 업무 능력으로
생성형 AI를 업무에 사용하다 보면 자연스럽게 프롬프트가 길어진다.
처음에는 단순히 다음과 같이 요청할 수 있다.
이 PDF에서 내용을 추출해 줘.
하지만 원하는 결과의 품질을 높이기 위해 하나둘 조건을 추가하게 된다.
예를 들면 다음과 같다.
PDF가 텍스트 기반인지 스캔 기반인지 먼저 확인할 것
텍스트를 직접 읽을 수 있다면 OCR을 사용하지 않을 것
표가 있으면 가능한 한 행과 열 구조를 유지할 것
페이지 번호를 함께 기록할 것
이미지 속 정보가 중요하다면 이미지도 분석할 것
제목, 본문, 표를 구분할 것
결과를 Markdown 형식으로 정리할 것
원문에 없는 내용을 추측해서 추가하지 않을 것
이 정도가 되면 단순한 질문이라기보다 하나의 업무 절차에 가까워진다.
예를 들어 매번 다음과 같은 프롬프트를 사용한다고 생각해 보자.
PDF 파일을 분석한다.
1. PDF가 텍스트 기반인지 스캔 기반인지 확인한다.
2. 텍스트를 직접 추출할 수 있으면 OCR을 사용하지 않는다.
3. 필요한 경우에만 OCR을 사용한다.
4. 제목과 섹션 구조를 유지한다.
5. 표는 가능한 한 행과 열 구조를 보존한다.
6. 중요한 이미지가 있으면 이미지를 별도로 분석한다.
7. 각 내용이 어느 페이지에 있는지 기록한다.
8. 원문에 없는 내용을 임의로 보완하지 않는다.
9. 최종 결과를 Markdown 문서로 정리한다.
한두 번 사용하는 것이라면 큰 문제가 없다.
하지만 같은 종류의 작업을 반복하기 시작하면 이야기가 달라진다.
매번 긴 프롬프트를 복사해서 붙여 넣어야 한다. 작업 방법이 개선되면 기존 프롬프트도 수정해야 하고, 여러 사람이 함께 사용한다면 사람마다 조금씩 다른 버전의 프롬프트가 생길 수도 있다.
이러한 반복적인 업무 지침을 좀 더 체계적으로 관리하기 위해 사용할 수 있는 개념이 AI Skill이다.
Skill은 무엇인가?
Skill을 가장 간단하게 표현하면 다음과 같다.
AI가 특정 종류의 업무를 수행하는 방법을 미리 정의해 놓은 재사용 가능한 업무 매뉴얼이다.
Prompt가
“이번에 무엇을 해줘.”
라고 요청하는 것이라면,
Skill은
“이런 종류의 일을 할 때는 이렇게 해.”
라고 미리 정의해 놓는 것에 가깝다.
예를 들어 PDF Content Extraction이라는 Skill을 만들어 다음과 같은 절차를 저장해 둘 수 있다.
PDF Content Extraction - PDF 유형 확인 - Embedded Text 확인 - 필요한 경우에만 OCR 사용 - 제목과 문서 구조 유지 - Table Structure 유지 - Page Number 기록 - 중요한 Image 분석 - Structured Output 생성
그렇다면 실제 작업에서는 사용자가 매번 위 내용을 모두 입력할 필요가 없다.
사용자는 단순히:
이 PDF에서 내용을 추출해 줘.
라고 요청하고, PDF 처리 방법에 대한 상세한 업무 규칙은 Skill에 저장해 둘 수 있다.
그렇다면 Skill은 결국 긴 Prompt 아닌가?
여기에서 가장 자연스러운 질문이 생긴다.
Skill도 결국 AI가 읽는 Instructions라면, 긴 Prompt를 파일에 저장해 놓은 것과 무엇이 다른가?
결론부터 이야기하면,
한 번 실행되는 순간만 놓고 보면 상당히 비슷하다.
Skill 안에 작성한 Instructions도 결국에는 AI가 읽어야 하기 때문이다.
개념적으로 보면 다음과 같다.
AI Context System Instructions + User Prompt + Skill Instructions + 필요한 Reference Information
따라서 Skill 자체가 새로운 AI 모델이거나 새로운 종류의 지능인 것은 아니다.
오히려 다음과 같이 이해하는 것이 더 정확하다.
Skill은 반복해서 사용하는 Prompt와 업무 절차를 재사용 가능하도록 구조화한 방식이다.
하지만 운영 관점에서는 단순한 긴 Prompt와 상당한 차이가 생긴다.
|
긴 Prompt |
Skill |
|
사용자가 직접 작성 |
미리 정의해 둘 수 있음 |
|
매번 입력 |
반복 사용 가능 |
|
복사·붙여넣기로 관리 |
파일과 디렉터리로 관리 |
|
여러 버전이 생기기 쉬움 |
중앙에서 관리 가능 |
|
버전 관리가 어려움 |
Git 등으로 버전 관리 가능 |
|
대부분 텍스트 하나로 구성 |
Reference, Script, Asset 등을 포함 가능 |
|
다른 작업과 섞이기 쉬움 |
업무 단위로 분리 가능 |
|
개인적인 사용에 적합 |
팀 단위 표준화에 적합 |
즉 Skill의 중요한 가치는 단순히 Prompt를 저장한다는 것이 아니라,
업무 방법을 하나의 독립적인 모듈로 만든다는 것
에 있다.
Prompt와 Skill의 가장 큰 차이
두 개의 차이를 아주 간단하게 표현하면 다음과 같다.
일반 Prompt는:
"이번 일을 이렇게 해."
Skill은:
"이 종류의 일은 이렇게 해."
라고 생각하면 이해하기 쉽다.
예를 들어 PDF를 한 번 처리한다면 긴 Prompt만으로 충분할 수 있다.
하지만 PDF 처리 작업을 매일 반복하고, 팀 전체가 동일한 방식으로 작업해야 한다면 Skill이 훨씬 유용해진다.
PDF 처리 원칙을 다음과 같이 정했다고 생각해 보자.
1. Embedded Text를 우선 사용한다. 2. OCR은 필요한 경우에만 사용한다. 3. Table Structure를 유지한다. 4. Page Number를 포함한다. 5. 원문에 없는 내용을 추측하지 않는다. 6. 결과를 Structured Output으로 작성한다.
이를 직원들이 각자 Prompt로 가지고 있는 것보다 하나의 Skill로 관리하는 편이 훨씬 일관성이 높다.
나중에 회사 정책이 바뀌어 모든 추출 결과에 Source Page를 반드시 표시한다.라는 규칙이 추가된다면 각자의 Prompt를 수정하는 대신 Skill 하나를 수정하면 된다.
SKILL.md
현재 여러 AI 개발 환경에서 사용하는 Skill 구조에서는 보통 하나의 Skill을 하나의 디렉터리로 구성한다.
예를 들어 PDF Content Extraction Skill은 다음과 같이 만들 수 있다.
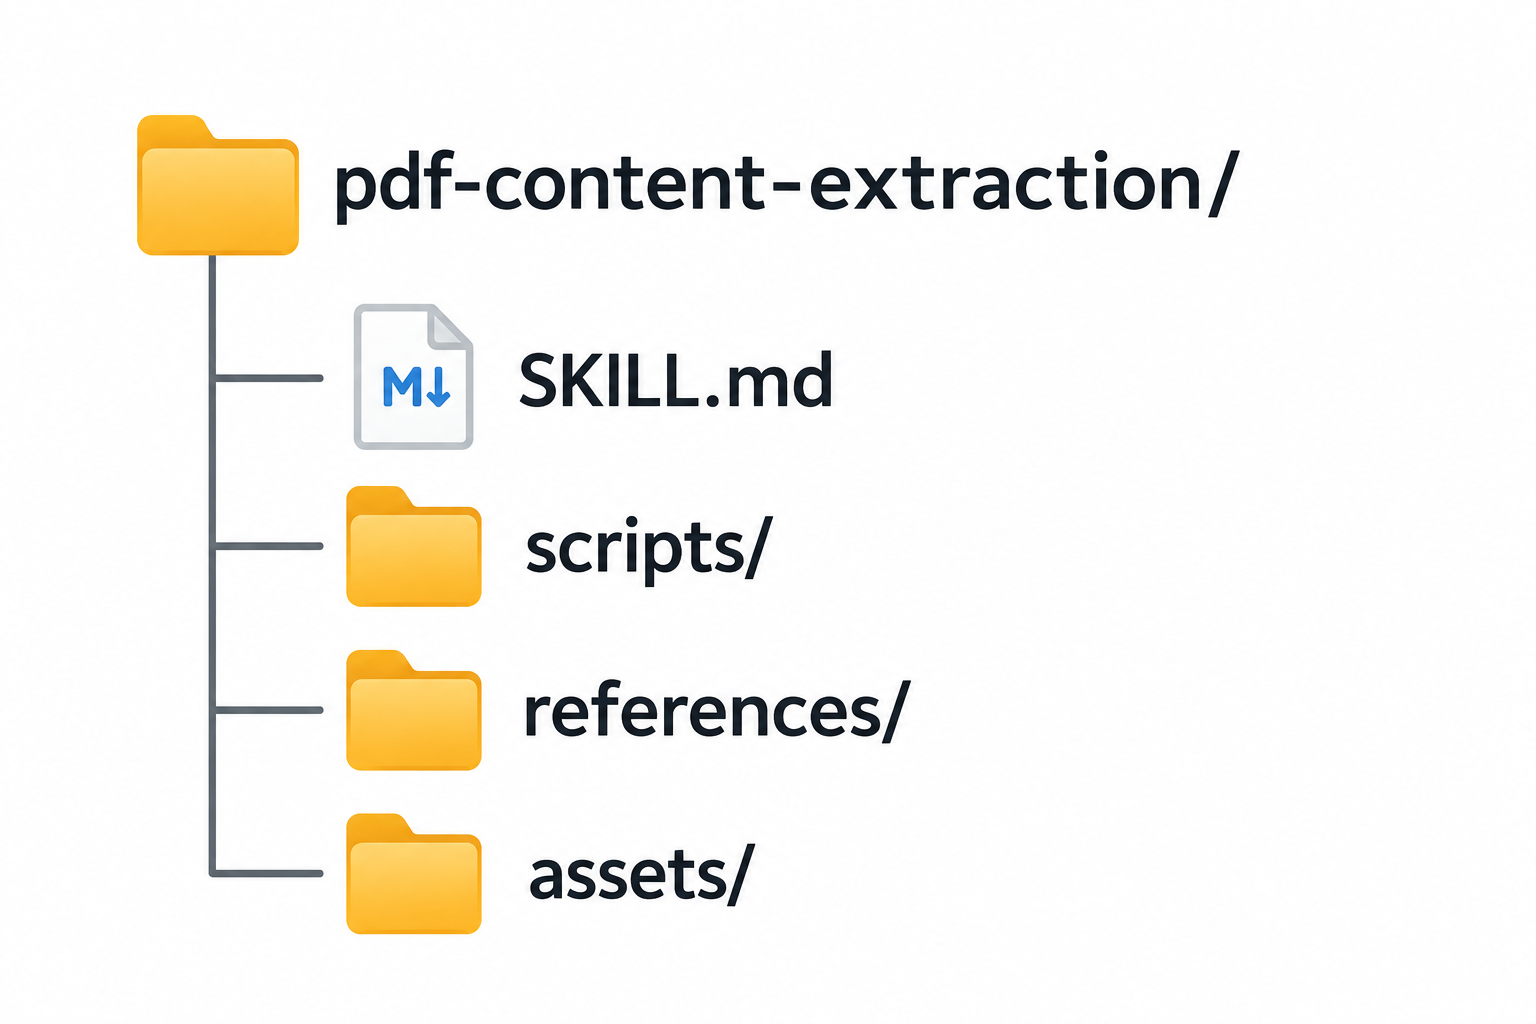
pdf-content-extraction/
├── SKILL.md
├── scripts/
├── references/
└── assets/
이 가운데 가장 중요한 파일이 SKILL.md다.
간단한 예는 다음과 같다.
|
name: pdf-content-extraction description: > Extract structured content from PDF documents, including headings, text, tables, and page references. Use when extracting or inspecting PDF content. # PDF Content Extraction When processing a PDF: 1. Determine whether the PDF contains embedded text. 2. Prefer direct text extraction when possible. 3. Use OCR only when necessary. 4. Preserve headings and document structure. 5. Preserve table rows and columns where possible. 6. Record page references. 7. Inspect important images when needed. 8. Do not invent missing content. 9. Return structured output. |
파일은 크게 두 부분으로 볼 수 있다.
YAML Frontmatter + Markdown Instructions
Frontmatter에는 Skill을 식별하기 위한 정보가 들어가고, Markdown 부분에는 실제 업무 절차가 들어간다.
Skill은 Instructions만 가지는 것이 아니다
Skill이 단순한 저장된 Prompt보다 더 유용해지는 부분이 바로 여기에 있다.
Skill 디렉터리에는 필요에 따라 추가 자료를 포함할 수 있다.
예를 들어 다음과 같은 구조를 생각할 수 있다.
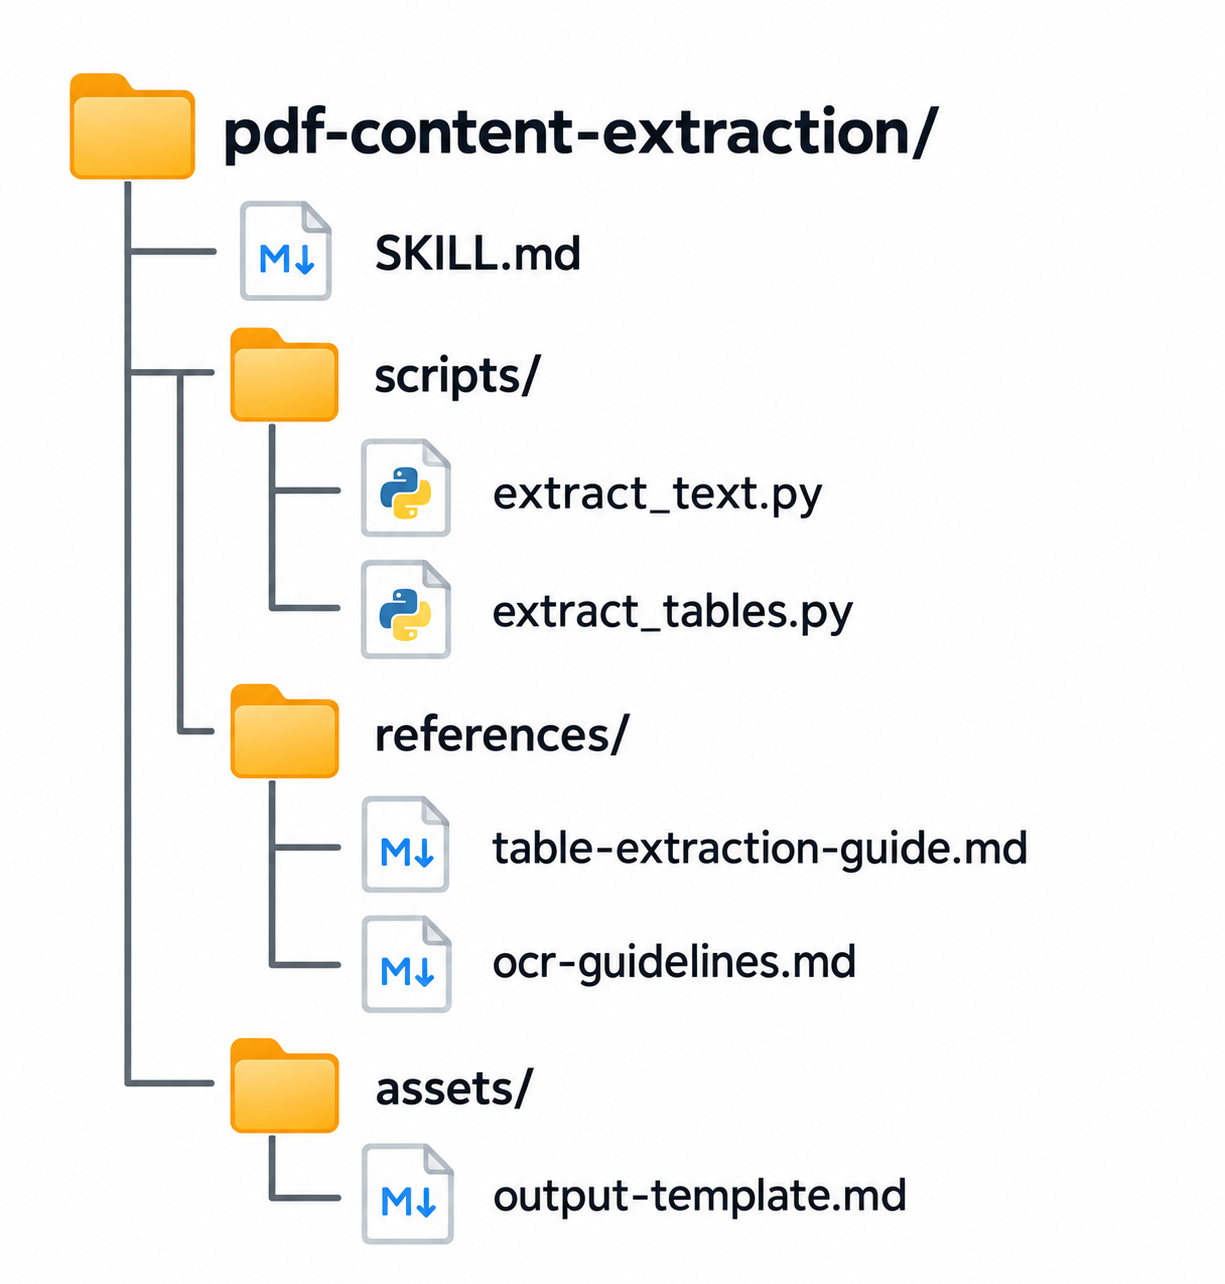
pdf-content-extraction/
├── SKILL.md
├── scripts/
│ ├── extract_text.py
│ └── extract_tables.py
├── references/
│ ├── table-extraction-guide.md
│ └── ocr-guidelines.md
└── assets/
└── output-template.md
각 디렉터리는 대략 다음과 같은 목적으로 사용할 수 있다.
scripts
반복해서 수행해야 하는 프로그램이나 자동화 코드를 저장한다.
extract_text.py extract_tables.py
references
작업 수행에 필요한 상세 지식이나 참고 문서를 저장한다.
ocr-guidelines.md table-extraction-guide.md
assets
최종 결과물을 만드는 데 필요한 템플릿이나 기타 리소스를 저장할 수 있다.
output-template.md report-template.xlsx
따라서 Skill은 점점 다음과 같은 형태가 된다.
Skill = Instructions + References + Scripts + Assets + Examples + Workflow
이 지점부터 Skill은 단순히 긴 Prompt를 파일에 저장한 것 이상의 의미를 갖기 시작한다.
Skill의 장점은 일관성과 재사용성
Skill의 가치는 특히 반복 업무에서 커진다.
예를 들어 조직에서 PDF 처리 규칙을 다음과 같이 정했다고 생각해 보자.
1. Embedded Text Extraction 우선
2. OCR 최소 사용
3. Table Structure 보존
4. Page Number 기록
5. 숫자는 원문 그대로 유지
6. 추측 금지
7. Structured Output 사용
각 사람이 이 규칙을 자신의 Prompt에 복사해 가지고 다닌다면 시간이 지나면서 조금씩 달라질 가능성이 높다. 누군가는 1번 규칙을 빼먹고, 누군가는 새로운 규칙을 추가하고, 누군가는 6개월 전 버전을 계속 사용할 수 있다.
Skill로 관리하면 업무 절차를 한곳에서 유지할 수 있다.
Agent Skill 정의 및 관련 링크
즉, Agent Skills는 특정 작업을 위한 Instructions, Scripts, References 등의 리소스를 하나의 디렉터리로 패키징하는 규약이다. 기본적으로 SKILL.md 파일을 사용하며, 필요에 따라 scripts/, references/, assets/ 등을 함께 구성할 수 있다.
https://agentskills.io/specification
Specification - Agent SkillsThe complete format specification for Agent Skills.
agentskills.io
https://docs.github.com/en/copilot/how-tos/copilot-cli/customize-copilot/add-skills
Adding agent skills for GitHub Copilot CLI - GitHub DocsModify Copilot's behavior and abilities when it works on particular tasks.
docs.github.com
원문 작성일: 2026. 9. 27. 22:23 · 카테고리: IT
#AI #AISkill #AgentSkills #PromptEngineering #LLM #AI업무자동화 #업무자동화 #프롬프트엔지니어링 #AI스킬 #LLMToken #Automation #인공지능